
Accelerate Compute: Big Data Processing & Query Optimization in Bangalore
We optimize sluggish big data processing pipelines, eliminate distributed compute bottlenecks, and slash cloud data warehouse spend. From tuning Spark executor memory to refactoring costly SQL queries on Snowflake and BigQuery, we boost query speeds by up to 10x.
Complete Data Processing & Tuning Capabilities
Eliminating data shuffles, data skews, and runaway cloud warehouse billing.
Apache Spark & Databricks Tuning
Eliminating data skews, optimizing shuffle partitions, tuning garbage collection, and configuring Adaptive Query Execution (AQE).
Explore Apache Spark & Databricks Tuning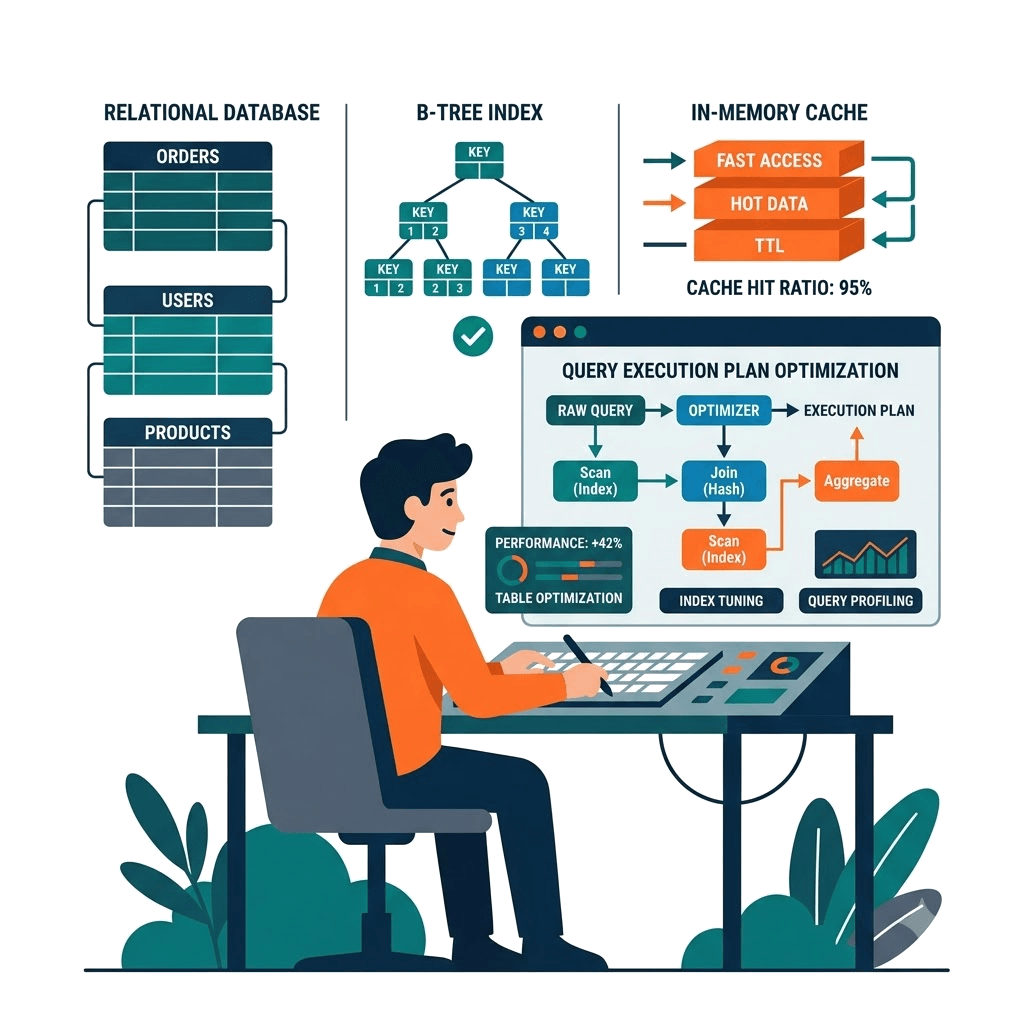
Snowflake Warehouse & Query Optimization
Right-sizing virtual warehouses, optimizing search optimization service, clustering keys, and eliminating runaway auto-suspend costs.
Explore Snowflake Warehouse & Query Optimization
Google BigQuery Cost & Performance Tuning
Partitioning and clustering large tables, converting costly full table scans into slot-efficient queries, and setting spend guardrails.
Explore Google BigQuery Cost & Performance Tuning
Trino / Presto Distributed Latency Tuning
Tuning query planner memory limits, dynamic filtering, join distribution types, and optimizing Parquet footer reading.
Explore Trino / Presto Distributed Latency Tuning
SQL Query Refactoring & Anti-Pattern Fixes
Rewriting inefficient Cartesian joins, window function bottlenecks, and unindexed subqueries to maximize database execution engines.
Explore SQL Query Refactoring & Anti-Pattern Fixes
FinOps Cloud Data Cost Auditing
Auditing cloud warehouse compute invoices, detecting zombie queries, and establishing automated budget alert thresholds.
Explore FinOps Cloud Data Cost AuditingOur Optimization & Tuning Toolset
Distributed compute profilers, execution plan visualizers, and FinOps platforms.
Compute Engines
Profiling & Plan Diagnostics
FinOps & Cost Governance
Storage & Layout Formats
Our Optimization Methodology
A systematic 6-step tuning protocol delivering measurable performance gains and cost savings.
Query Profiling & Cost Audit
Extracting query history logs to identify top 10% most expensive queries consuming 90% of compute budget.
Execution Plan (EXPLAIN) Analysis
Diagnosing data spill to disk, broadcast join failures, table scan volumes, and execution bottlenecks.
Data Model & Partition Optimization
Implementing intelligent date partitioning, clustering keys, and Parquet compaction to reduce bytes scanned.
Compute Engine Parameter Tuning
Tuning Spark executor cores, memory overhead, shuffle partitions, and warehouse autoscaling thresholds.
SQL Refactoring & Code Rewriting
Restructuring complex queries, eliminating redundant aggregations, and leveraging materialized views.
Benchmark Verification & Cost Gating
Running side-by-side benchmark tests confirming latency drops, and locking in automated cost guardrails.
Enterprise Optimization Standards
Strict latency, cost reduction, and computational efficiency guarantees.
Minimum 40% Compute Cost Reduction
Every engagement targets a minimum 40% reduction in cloud warehouse compute consumption.
Zero Data Spill to Disk
Eliminating Spark and Snowflake memory spills to disk by calibrating memory allocations correctly.
Partition Pruning Enforcement
Ensuring 100% of analytical queries benefit from partition pruning to avoid wasteful full-table scans.
Sub-Minute Dashboard SLAs
Guaranteeing executive reporting dashboards load within 60 seconds even against billions of records.
Automated Zombie Query Termination
Configuring aggressive warehouse timeout limits terminating runaway Cartesian product queries.
Continuous FinOps Monitoring
Weekly cost anomaly alerts catching unanticipated compute spikes before monthly invoice delivery.
Featured Query Optimization Case Study
Slashing Snowflake cloud spend by 54% while accelerating BI reporting 6x.
Snowflake & Spark Performance Optimization for FinTech Analytics
Audited and refactored over 150 daily analytical SQL models and Spark batch jobs for a financial services firm. Eliminated full table scans through cluster keys, right-sized virtual warehouses, and cut monthly Snowflake spend from $42,000 to $19,300 while reducing BI report latency from 14 minutes to 2 minutes.
Why Partner With Render Infotech?
Over 16+ years and 500+ successful deployments, we have established an engineering reputation in Bangalore for technical rigor, architectural transparency, and zero compromise on code quality.
- Dedicated In-House Engineers: Direct communication with senior specialists, not junior offshore intermediaries.
- 100% IP & Code Ownership: Full source code, database structures, and copyright ownership transferred upon milestone sign-off.
- Performance SLA Guarantee: Contractually committed speed benchmarks, security verification, and high-availability SLAs.
- Transparent Weekly Sprints: Live staging environments, progress demos, and clear milestone accounting.
Enterprise Performance Commitment
Every project we engineer is guaranteed to pass rigorous vulnerability scans, mobile responsiveness checks, and automated regression testing prior to production launch.
Bangalore Engineering Center
Kalyan Nagar, Bengaluru — Local Support & Global Standards
Big Data Processing & Query Optimization Services FAQs
Answers to common technical, pricing, and timeline questions regarding our Big Data Processing & Query Optimization Services services.
Ready to Architect Your Solution?
Connect directly with our senior technical architects in Bangalore for an architectural consultation, technology recommendation, and formal scope estimate within 24 hours.
Request a Big Data Processing & Query Optimization Services Proposal
Fill out your technical brief below to receive an architectural estimate within 24 hours.